Als je een biljet onder het licht houdt, zie je een verborgen afbeelding. Dit is een watermerk, en het bewijst dat het biljet authentiek is. Sinds deze zomer is het onder de AI Act verplicht voor AI-aanbieders om ook een watermerk aan AI-gegenereerde content mee te kunnen geven. Hiermee moet herkend kunnen worden dat tekst, afbeeldingen, audio of video met AI gegenereerd zijn.
Maar hoe verstop je een watermerk in een tekst, zonder pixels of papier? En hoe krijg je dat watermerk vervolgens weer te zien? Wij leggen het hier uit!
Watermerken in tekst
Taalmodellen en statistiek
Om te beginnen is het belangrijk om hoogover te snappen hoe taalmodellen werken. Een taalmodel (LLM) neemt een selectie aan woorden als input, en probeert daaruit het volgende woord te voorspellen. Hiervoor berekent het een waarschijnlijkheid voor elk mogelijk volgend woord. Dus stel, mijn tekst is als volgt:
Soev.ai is een platform voor het bieden van …
Dan maakt het model eerst een voorspelling van welke woorden het meest waarschijnlijk zijn, om hier vervolgens een keuze uit te maken:
| Volgend woord | Kans |
|---|---|
| soevereine | 50% |
| diensten | 30% |
| Nederlandse | 10% |
| artificial | 10% |
| (overige) | 0% |
Soev.ai is een platform voor het bieden van diensten …
Sturen van de woordkeuze
Om een watermerk achter te laten willen we de woordkeuze van het model beïnvloeden. Dit willen we doen zonder dat het impact heeft op de kwaliteit van antwoorden, of merkbaar is voor de gebruiker. Hierbij maken we gebruik van een sleutel. Een sleutel is in dit geval niets meer of minder dan een klein lijstje aan cijfers.
sleutel = (12, 105, 9, 33)
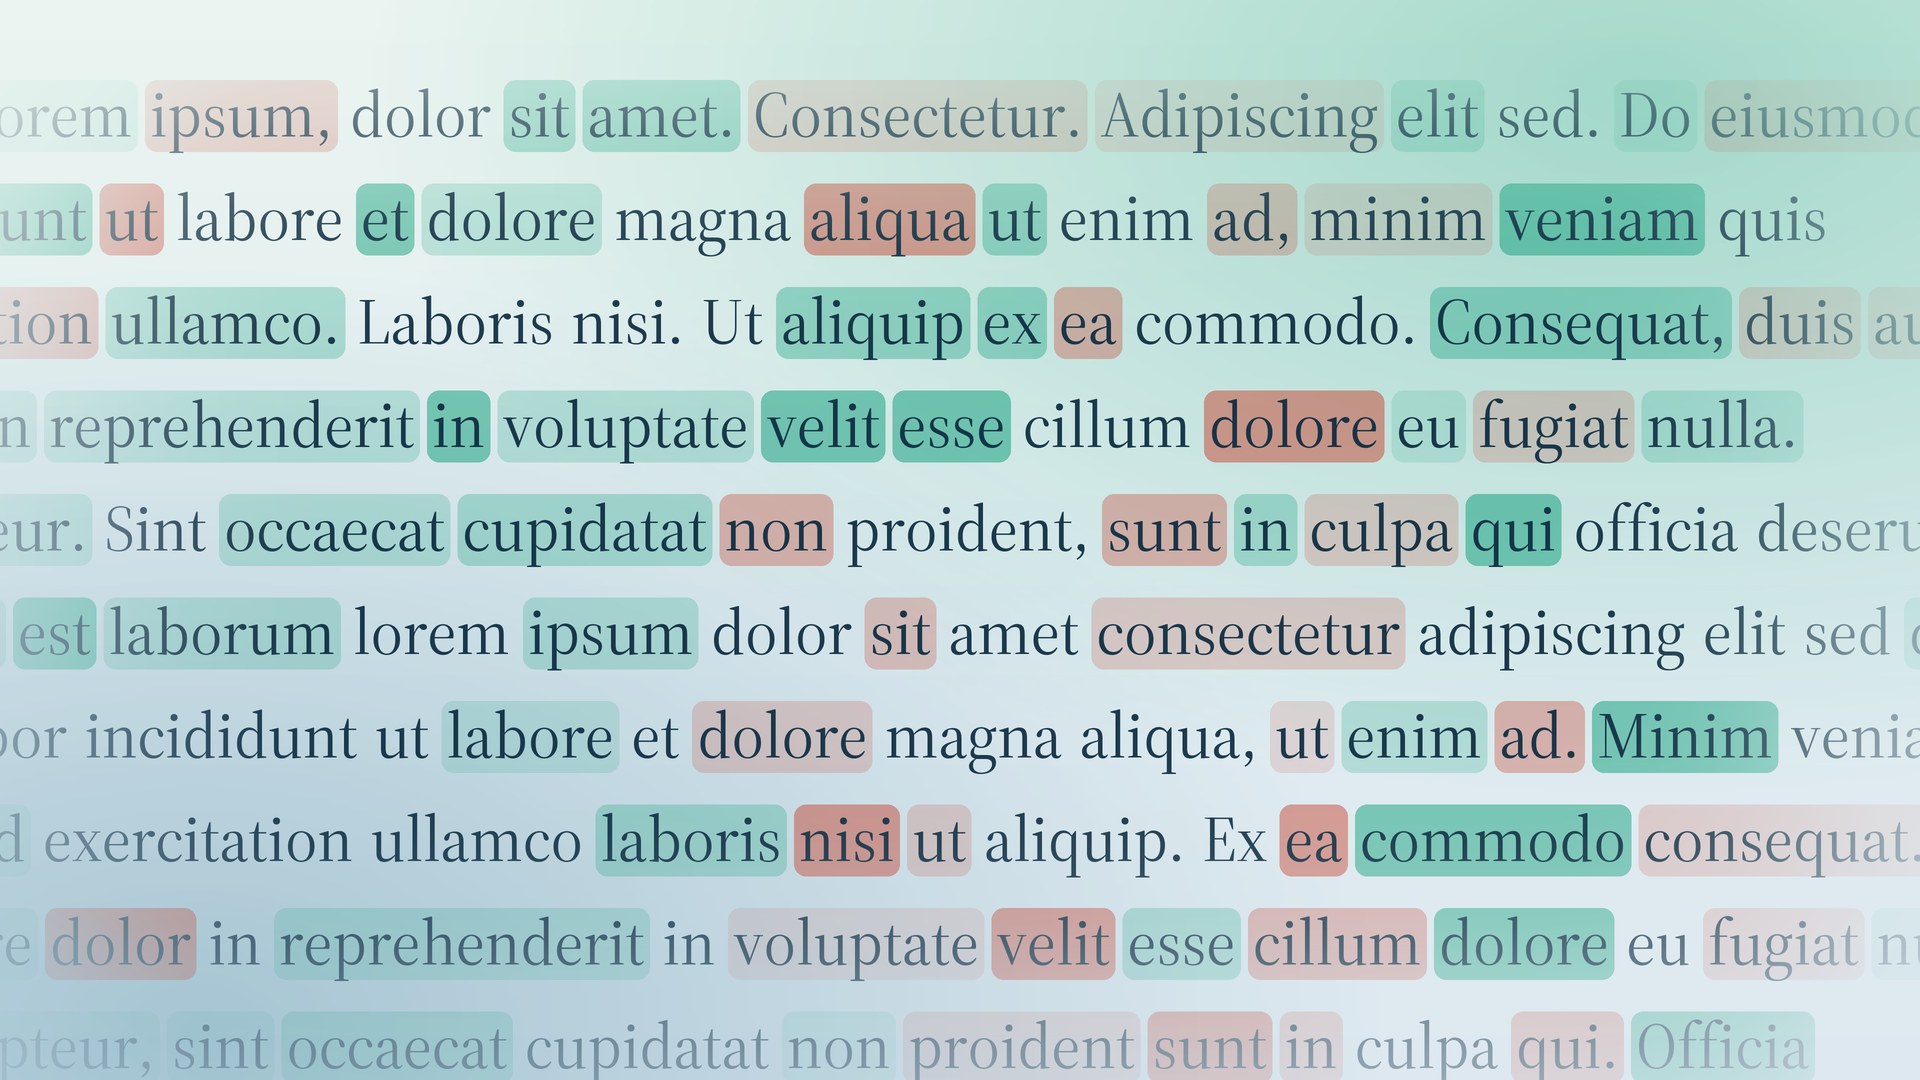
Met de sleutel willen we vervolgens bepalen welke woorden voorkeur krijgen in de selectie. Hiervoor gebruiken we de laatste paar woorden (4) in combinatie met de sleutel ('hashing' voor de technici onder ons). In ons voorbeeld eindigt de tekst op "het bieden van". Samen met de sleutel gebruiken we die woorden om alle mogelijke volgende woorden te husselen en in twee groepen te verdelen: een groene lijst en een rode lijst. Ongeveer de helft van de woorden komt op de groene lijst, de andere helft is rood.
Het is heel belangrijk dat deze verdeling er willekeurig uitziet, ook al is die dat niet. Met dezelfde sleutel en dezelfde vorige 4 woorden komt er altijd dezelfde verdeling uit. Na andere woorden, of met een andere sleutel, ziet de verdeling er weer compleet anders uit.
Stel dat na "het bieden van" het woord "diensten" op de groene lijst valt. Dan geven we alle groene woorden een duwtje in de rug voordat het model zijn keuze maakt:
| Volgend woord | Kans (normaal) | Kans (met watermerk) |
|---|---|---|
| soevereine | 50% | 18% |
| 🟢 diensten | 30% | 76% |
| Nederlandse | 10% | 3% |
| artificial | 10% | 3% |
Het model kiest nog steeds zelf, en "soevereine" blijft een prima optie. Maar de kans dat het een groen woord wordt, is flink groter.
Waarom gaat de kwaliteit hier niet van achteruit? Het duwtje helpt alleen woorden die het model zelf al redelijk vond. Is het model heel zeker van zijn zaak, bijvoorbeeld "Den" gevolgd door "Haag" met 99,9% kans, dan verandert er vrijwel niks. Het watermerk zit dus vooral in de momenten waarop er meerdere goede opties zijn.
Het watermerk terugvinden
Voor een lezer ziet een tekst met watermerk er normaal uit. Je kunt de groene woorden niet zien, want welke woorden groen zijn hangt af van de sleutel. Wie de sleutel heeft, kan het watermerk wel terugvinden. Daarvoor is het taalmodel zelf niet nodig.
We lopen de tekst woord voor woord door en kijken telkens: was dit woord groen, gegeven de woorden ervoor? Daarna tellen we hoeveel groene woorden we tegenkomen.
- Een tekst zonder watermerk (bijvoorbeeld door een mens geschreven) weet niets van onze groene lijst. Gemiddeld is dan ongeveer de helft van de woorden toevallig groen.
- Een tekst met watermerk is steeds een klein beetje richting groen geduwd. Daardoor is een (iets) groter deel van de woorden groen.
Om te controleren of het watermerk aanwezig is moeten we simpelweg de sleutel toepassen, en het percentage groene woorden controleren. Je kunt het vergelijken met een munt die steeds op kop valt. Na drie keer kop is er nog niets aan de hand, maar na honderd keer kop weet je zeker dat er met de munt is gesjoemeld. Hier is de werking hetzelfde: in een tekst van 200 woorden verwacht je zo'n 100 groene woorden. Vind je er 125, dan is de kans dat dit toeval is ongeveer 1 op de 5000.
Een voorbeeld
Theorie is leuk en aardig, maar laten we het ook even op de proef stellen. We hebben het open taalmodel Gemma 4 (31B) van Google twee keer gevraagd om een korte, luchtige column over de AI Act te schrijven. Eén keer met watermerk en één keer zonder. Kun jij zien welke gewatermerkt is?
Tekst A
Stel je voor dat Europa besluit om voor het eerst verkeersregels in te voeren voor het wilde westen van de kunstmatige intelligentie. Dat is in essentie wat de AI Act is. Nu we allemaal experimenteren met chatbots die onze e-mails schrijven of plaatjes maken van katten in ruimtepakken, wil Brussel voorkomen dat de techniek ons volledig uit handen glipt. Het is eigenlijk een soort digitale veiligheidsgordel: we mogen best hard rijden en vernieuwen, zolang we maar niet blindelings het ravijn in stormen met tools die discrimineren of onze privacy volledig opvreten. …
Tekst B
Daar gaat Brussel weer: een dik wetboek vol regels voor iets dat we eigenlijk nog niet eens helemaal begrijpen. De Europese AI Act is een feit en probeert de wilde westen van de kunstmatige intelligentie te temmen. Het idee is nobel; we willen geen digitale dictator of algoritmes die ons discrimineren bij een sollicitatie. In plaats daarvan krijgen we een soort verkeersreglement voor robots, waarbij sommige AI-systemen simpelweg verboden worden en andere streng in de gaten worden gehouden. …
Per woord zie je weinig verschil. In beide teksten is ongeveer de helft van de woorden groen, en fel gekleurde woorden zijn in allebei zeldzaam. Pas als je alles bij elkaar optelt, komt het watermerk boven:
| Tekst | Hoeveel meer groen dan verwacht (z)? | Kans dat het toeval is |
|---|---|---|
| A (met watermerk) | 3,1 | ongeveer 1 op 1.000 |
| B (zonder watermerk) | 0,6 | groot: precies wat je bij toeval verwacht |
De score z zegt hoeveel standaarddeviaties het aantal groene woorden boven het toevalsniveau ligt. De tekst zonder watermerk heeft een lage score, die willekeur aangeeft. De tekst met watermerk heeft z = 3,1: de kans dat dat toeval is, is ongeveer één op duizend.
Kunnen we nu alle AI-gegenereerde teksten detecteren?
Helaas zijn we nog niet zo ver. Er zitten nog een aantal haken en ogen aan. Allereerst: de sleutel waarmee de tekst gegenereerd is moet gedeeld worden om het watermerk te herkennen. Het is aan bedrijven niet verplicht deze sleutel te delen. Wel moeten aanbieders een gratis methode aan klanten bieden, om te testen of een tekst AI-gegenereerd is - bijvoorbeeld met een API.
Daarnaast is het vaak ook eenvoudig om een watermerk uit te wissen. Een aantal zwakkere punten zijn:
- Herschrijven wist het watermerk uit. Laat je de tekst parafraseren door een mens of door een ander taalmodel, dan verdwijnen de groene woorden en daarmee het watermerk. Hieronder proberen we het zelf.
- Korte teksten zijn lastig. In één zin zitten te weinig woorden om met zekerheid iets te kunnen zeggen.
- Weinig keuze betekent weinig watermerk. Bij feitelijke antwoorden, lijstjes of programmeercode ligt de woordkeuze vaak vast. Dan is er weinig ruimte om te sturen.
Op de proef
Woorden vervangen
Hoe makkelijk krijg je het watermerk weg? We lieten Gemma, zonder watermerk, korte stukjes van één tot vijf woorden herschrijven in de column met watermerk van hierboven, en pasten steeds meer van die herschrijvingen toe.
| Vervangen woorden | Aantal | Gemiddelde z | 8 van de 10 keer tussen |
|---|---|---|---|
| 0% | 0 | 3,10 | 3,1 – 3,1 |
| 5% | 10 | 2,75 | 2,4 – 3,1 |
| 10% | 19 | 2,58 | 2,2 – 2,8 |
| 15% | 29 | 2,40 | 2,0 – 2,8 |
| 20% | 38 | 2,27 | 1,6 – 2,8 |
| 25% | 48 | 2,12 | 1,4 – 2,7 |
| 30% | 57 | 2,00 | 1,4 – 2,5 |
| 35% | 66 | 1,81 | 1,4 – 2,5 |
| 40% | 76 | 1,54 | 1,0 – 2,1 |
| 45% | 86 | 1,28 | 0,8 – 1,9 |
| 50% | 95 | 1,14 | 0,5 – 1,8 |
| 55% | 105 | 1,02 | 0,4 – 1,7 |
| 60% | 114 | 0,90 | 0,4 – 1,3 |
| 65% | 124 | 0,74 | 0,5 – 1,1 |
| 70% | 133 | 0,70 | 0,7 – 0,7 |
Het bewijs zakt geleidelijk. Met 10% herschreven woorden is het gemiddeld nog z = 2,6: twijfelachtig, en niet genoeg om iemand op aan te spreken. Bij de helft is het z = 1,1, en bij 70% blijft er z = 0,7 over: niet meer te onderscheiden van toeval.
Korte en lange teksten
Hoe lang moet een tekst zijn voordat je het watermerk zeker herkent? We lieten Gemma twintig keer een lange column over de AI Act schrijven met watermerk, en twintig keer zonder. Daarna keken we telkens alleen naar het begin van elke tekst: de eerste 50 tokens, de eerste 100, enzovoort tot 1.000.
| Tokens | Met watermerk: z | Kans op toeval | Zonder watermerk: z |
|---|---|---|---|
| 50 | 1,42 | 1 op 13 | 0,06 |
| 100 | 2,50 | 1 op 163 | -0,08 |
| 150 | 3,07 | 1 op 934 | 0,08 |
| 200 | 3,24 | 1 op 1.673 | 0,11 |
| 250 | 3,71 | 1 op 9.650 | 0,18 |
| 300 | 3,99 | 1 op 30.269 | 0,17 |
| 350 | 4,33 | 1 op 137.212 | 0,12 |
| 400 | 4,61 | 1 op 496.686 | 0,10 |
| 450 | 4,81 | 1 op 1.325.115 | 0,15 |
| 500 | 5,02 | 1 op 3.870.607 | 0,14 |
| 550 | 5,25 | 1 op 13.149.312 | 0,11 |
| 600 | 5,31 | 1 op 18.243.975 | 0,08 |
| 650 | 5,52 | 1 op 58.997.109 | 0,09 |
| 700 | 5,82 | 1 op 329.848.560 | 0,03 |
| 750 | 5,96 | 1 op 792.902.151 | 0,02 |
| 800 | 6,16 | 1 op 2.663.914.113 | -0,08 |
| 850 | 6,34 | 1 op 8.704.539.800 | -0,07 |
| 900 | 6,50 | 1 op 24.086.689.638 | -0,03 |
| 950 | 6,66 | 1 op 73.038.660.439 | -0,07 |
| 1000 | 6,74 | 1 op 126.273.283.421 | -0,12 |
Bij 50 tokens, zo'n 35 woorden, is er nauwelijks bewijs: gemiddeld z = 1,4, een kans op toeval van 1 op 13. Bij 100 tokens, zo'n 70 woorden, is het z = 2,5: ongeveer 1 op 160. Daarna groeit het gestaag. Vanaf zo'n 450 tokens, ruim 300 woorden, is de kans op toeval gemiddeld kleiner dan één op een miljoen. Bij 1.000 tokens is het gemiddeld z = 6,7: ongeveer één op 126 miljard. De teksten zonder watermerk blijven over de hele lengte rond nul hangen.
Creatieve en feitelijke teksten
Het watermerk kan alleen sturen als het model echt iets te kiezen heeft. Maakt dat uit voor het soort tekst? We gaven Gemma acht opdrachten over hetzelfde onderwerp, de AI Act. Vier creatieve: een column, een kort verhaal, een gedicht en een dialoog tussen een chatbot en een Brusselse ambtenaar. En vier feitelijke: een uitleg van de wet, de verplichtingen voor aanbieders, de risicocategorieën en wat de wet betekent voor een bedrijf met een chatbot. Elke opdracht deden we vijf keer, steeds met watermerk. Om eerlijk te vergelijken, meten we elke tekst over de eerste 250 tokens.
| Soort | Opdracht | Gemiddelde z | Laagste – hoogste z |
|---|---|---|---|
| creatief | column | 2,64 | 1,6 – 3,4 |
| creatief | kort verhaal | 2,12 | 1,4 – 3,2 |
| creatief | gedicht | 4,14 | 2,9 – 5,4 |
| creatief | dialoog | 2,78 | 1,7 – 5,6 |
| feitelijk | uitleg | 1,32 | 0,6 – 1,9 |
| feitelijk | verplichtingen | 2,24 | 1,4 – 3,0 |
| feitelijk | risicocategorieën | 1,42 | 0,4 – 2,7 |
| feitelijk | chatbot-bedrijf | 1,80 | 0,9 – 2,9 |
Creatieve teksten dragen het watermerk duidelijk sterker: gemiddeld z = 2,9, tegen z = 1,7 voor feitelijke teksten. Het gedicht springt eruit met gemiddeld z = 4,1. Per tekst verschilt het flink: creatieve teksten scoren van z = 1,4 tot 5,6, feitelijke van z = 0,4 tot 3,0. Hoe vaster de woordkeuze ligt, hoe minder ruimte er is om te sturen.
In de praktijk betekent dit dat een AI-gegenereerde column of een AI-gegenereerd gedicht beter te herkennen is, terwijl een zakelijke uitleg, code, wiskunde, of een samenvatting langer moet zijn voor hetzelfde bewijs. Minder creativiteit leidt tot een minder sterk watermerk.
Wat betekent dit voor jouw organisatie?
Voor de meeste organisaties verwachten wij niet veel impact. Aanbieders van AI-modellen zijn verantwoordelijk voor het watermerken, als organisatie zou je hier weinig van moeten merken. Bij twijfel kun je voortaan checken of een stuk tekst gegenereerd is door een specifieke aanbieder.
Wees bewust van het feit dat watermerken niet 'waterproof' is. Gebruikers kunnen het watermerk verwijderen met eenvoudige technieken.
Tot slot is er een kwestie die vaak over het hoofd wordt gezien: wie heeft de sleutel? Om te controleren of een tekst een watermerk draagt, ben je afhankelijk van de aanbieder van het model, vaak via een tool of API van diezelfde aanbieder. Als je volledig grip op je data wilt houden, is het handig om daar vooraf over na te denken.
Benieuwd wat de AI-verordening voor jouw organisatie betekent, of hoe Soev.ai omgaat met transparantie en watermerken? Neem contact met ons op!